换了张考卷,国产模型掉了 13 分:AA v5 的 17 个事实
Tokrace 小数据 · 17 个事实 · 11 张图 · 数据来自 Artificial Analysis
更新日期:2026-11-01
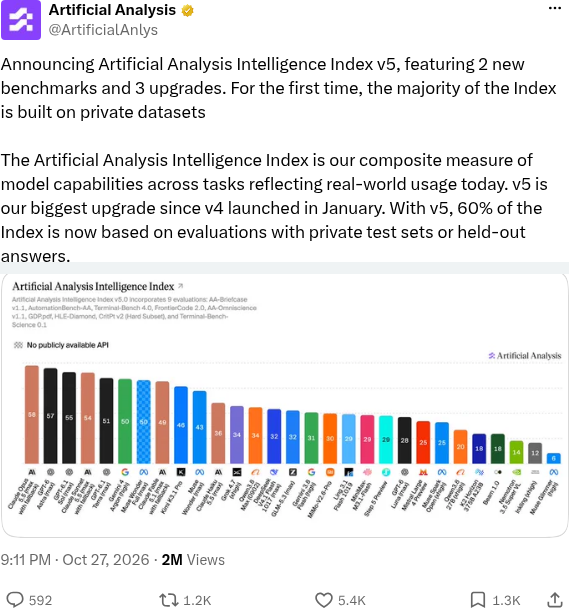
10 月 27 日,Artificial Analysis 发布 Intelligence Index v5。AA 的发布帖有 200 万次浏览。新版一上线,几乎所有模型都掉了分,国产模型掉得最多:同一批模型,换一套题,平均少了 12.4 分。
国产模型是被针对了,还是在旧榜上本来就虚高?下面 17 个事实,全部来自 AA 公开的分数和方法论。
1. 考卷换掉了三成,而且大部分看不到
v4.3.2 的 25% 权重被删掉,v5 的 30% 是新加的;60% 的权重落在私有题上。
被删的是 GDPval-AA、SciCode 和长上下文测试 AA-LCR。新加的是 Cognition 出的私有代码基准 FrontierCode 2.0,和在终端里做科研任务的 Terminal-Bench-Science,各占 15%。HLE 换成精修版 HLE-Diamond,CritPt 换成 40 道私有难题,AA-Omniscience 升到 v1.1。
AA 自己的说法是:这是 v4 以来最大的一次升级,第一次让指数的大部分建立在私有数据上。
2. 不只是国产,几乎所有模型都在掉分
前后两版都有分的 77 个模型条目里,只有 8 个涨分。
涨分的 8 个全是 Anthropic 和 OpenAI 的顶配:Opus 5.5 max/xhigh,GPT-6 Astra 的 max/xhigh/high/medium,GPT-6.1 Sol 的 max/xhigh。Opus 5.5 max 从 57.6 到 58.4,Astra max 从 52.7 涨到 56.9,Sol max 从 51.8 涨到 54.5。
剩下的全在掉:Claude Sonnet 5.5 max 掉 1.8,Gemini 4 Argon 掉 2.1,Meta 的 Muse Wonder Full 掉 6.1。
3. 但国产掉得约是别人的两倍
17 个国产模型条目平均 -12.4 分,其余 60 个平均 -6.8 分。
“只有国产在掉”不对,“国产没有特别掉”也不对。所有人都在退潮,国产退得更快。
4. 同一分数段比,国产仍多掉约 6 分
v4.3.2 时同在 42–47 分的模型:国产平均 -13.9,其他平均 -8.2。
国产模型在旧榜上大多挤在 42–47 分,这个区间本身就是重灾区:美国的 Grok 4.7 三个档位都掉了 11–12 分。但同区间对比,国产还是比别人多掉了 5.7 分。
5. 掉得最狠的是小米
MiMo-V2.6-Pro:46.3 → 29.9,-16.4 分,从第 27 名跌到第 45 名。
阶跃 Step 5 Preview 掉了 15.2,蚂蚁 Ling 3.1 Flash 1019 掉了 14.4。Ling 在 v5 上线前一天刚拿到 43.9 的旧版分数,第二天就成了 29.5。
6. Kimi 从第 5 跌到第 22,仍是开放权重第一
Kimi K3.1 Pro:55.1 → 46.0。
在旧榜上,Kimi K3.1 Pro 排第 5,压过 GPT-6 Astra;到了新榜,它落后 Opus 5.5 12.4 分。AA 把开放权重和闭源头部的差距从 3 分改写成 12 分,算的就是 Kimi。不过 Kimi K3.1 Pro 的权重还没放出来。
7. 能下载的最好模型,排在 Haiku 后面
DeepSeek V4.1 Flash 1017 32.5、GLM-5.3 31.7,Claude Haiku 5.5 36.2。
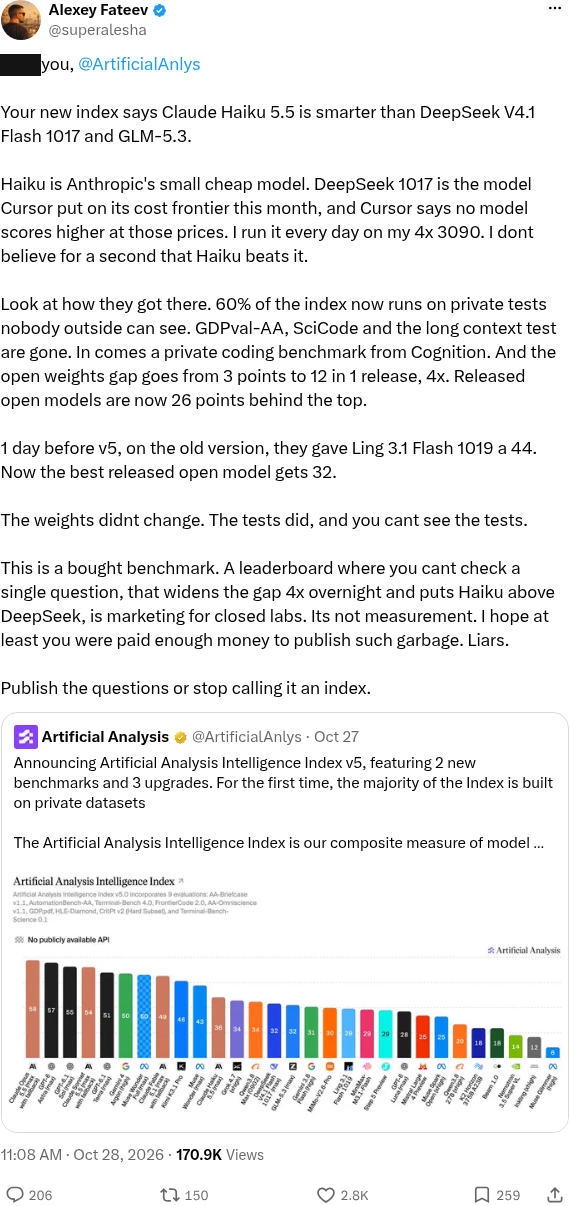
已发布权重的模型里,最高分的就是这两个,落后榜首 26 分,也低于 Anthropic 的小模型 Haiku。这一条点燃了 X 上的反弹:开发者 Alexey Fateev 说他每天在 4 张 3090 上跑 DeepSeek,“一秒也不信 Haiku 比它强”,帖子拿到 2,895 个赞、17 万次浏览。
8. 单项差距最大的,是新加的科学终端题
Terminal-Bench-Science:Opus 5.5 59.0%,DeepSeek 12.9%,GLM 9.5%,MiMo 5.7%,阶跃 2.4%。
这项考的是在命令行环境里连续做科研计算任务,权重 15%。v5 每题输出 token 的中位数从 3.5 万涨到 5.9 万,这一项就吃掉约三分之一。国产条目这一项的中位数是 4.1%,其他模型 13.6%。
不只是国产会在这里失分:Grok 4.7 只有 4.8%,Claude Haiku 5.5 也只有 20.0%。
9. 26 分差距里,科学终端一项占了 7 分
按 AA 公布的权重和分项成绩复算:DeepSeek 在这一项上少拿 6.9 分,GLM 7.4,Qwen 7.1,MiMo 8.0。
这四个模型和 Opus 5.5 的总差距在 25–28 分上下,科学终端约占其中 27%–30%。第二大缺口是 HLE-Diamond,4–5 分;第三是 FrontierCode 2.0,约 3 分。
Kimi 是例外。它的差距只有 12.2 分,分散在各项上,其中科学终端 3.7 分,HLE-Diamond 3.1 分,FrontierCode 3.1 分。
10. 旧 HLE 换成 HLE-Diamond,头部涨、国产跌
Opus 5.5 61.4% → 67.9%;GLM-5.3 42.3% → 17.9%,MiMo 49.4% → 15.2%。
国产模型在这项上平均掉 18.4 个百分点,其他模型平均掉 8.4。
这一项有一部分是结构性的。旧 HLE 用的是 2,158 道纯文本题;HLE-Diamond 共 1,000 题,其中 272 道带图,不支持图像输入的模型只能拿到文字,但仍按 1,000 题计分。对纯文本模型来说,这是一笔考前就定下的扣分。
11. 被删掉的三项,恰是国产差距最小的
GDPval-AA:Opus 5.5 1866,Kimi 1858,DeepSeek 1746,GPT-6 Astra 1584。
长上下文测试 AA-LCR 前三全是国产:阶跃 88.3%,Kimi 和 MiMo 都是 86.3%,Opus 5.5 是 84.7%。SciCode 上 MiMo 60.9%、Kimi 60.8%,落后 Opus 6 个点,但领先 GPT-6 Astra。
这三项合计占旧指数的 25%。删掉它们,国产模型失去的是一块不落下风的地盘。
12. 新代码题:最好的开放模型落后 18 个点
FrontierCode 2.0:Opus 5.5 46%,DeepSeek V4.1 Flash 28%。
这是 Cognition 的私有基准,评判标准是仓库维护者会不会合并 agent 提交的修改。GPT-6 Astra、Terra 和 Sonnet 都在 42%,Kimi 25.5%,GLM 21.6%,阶跃 12.0%。
13. 知识题也换了版本,两款国产模型分数转负
AA-Omniscience v1.1:MiniMax M3.1 Flash 从 16 分降到 -6 分,MiMo V2.6 Pro 从 8 分降到 -5 分。
这项分数可以为负。v1.1 删掉了已经饱和、已经公开的题目,补了新题。全体平均只降 1.9 分,中位数 0.6;AA 点名降幅最大的两个都是国产。
14. 新的第一名,你用不到
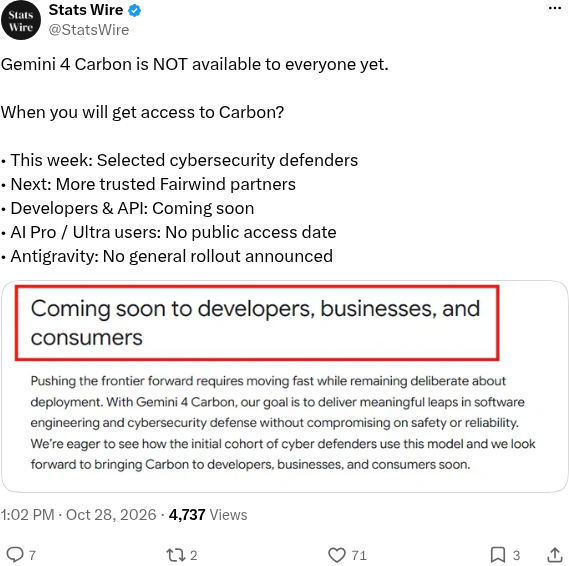
Gemini 4 Carbon 10 月 28 日上榜,59.4 分,比 Opus 5.5 高 1 分。
它在 9 项里领先 4 项:HLE-Diamond、科学终端、知识准确和 AutomationBench。它的幻觉率是 11%,Opus 5.5 和 GPT-6 Astra 都是 50%。但 AA 原话是,Carbon 正在“向部分用户推送,尚未公开可用”,榜单上它的标签是“No publicly available API”。
15. 同样 32 分上下,价格差 17 倍
每道指数任务的成本:DeepSeek V4.1 Flash $0.60,Qwen3.8 Max $10.02。
两者分数只差 1.1 分,Qwen3.8 Max 的单题成本和第二名 Opus 5.5 max($10.04)几乎一样。在另一端,GPT-6.1 Sol max 只比 Opus 低 4 分,成本却只有八分之一,每题 $1.27。
16. 同一个模型,档位能差出 24 分
Claude Opus 5.5:low 34.5 分($0.98),max 58.4 分($10.04)。
GPT-6.1 Sol 的 low 到 max 是 34.5 到 54.5 分,差距从 v4.3 的 10 分扩大到 20 分。v5 的任务更长,推理预算多一档,分数就高一截。厂商宣传时报的是哪一档,现在差别更大了。
17. 一半是水分,一半是真差距
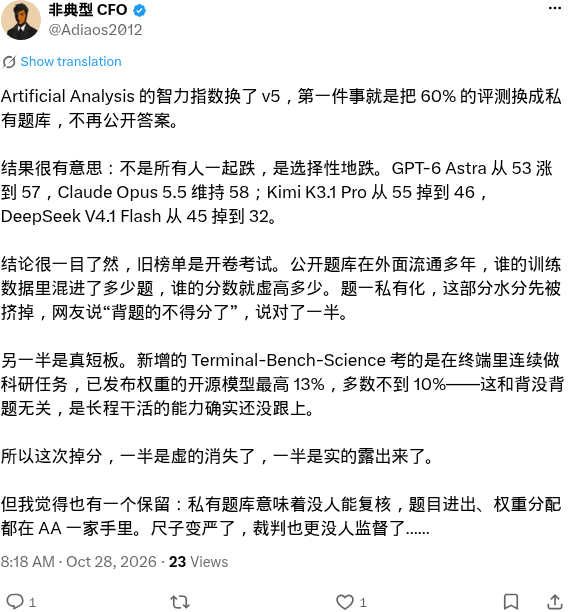
私有题挤掉了旧题上可能的背题红利,但科学终端和新代码题上的差距,跟背题无关。
“非典型 CFO”的总结最准确:一半是虚的消失了,一半是实的露出来了。尺子变严了,裁判也更没人监督了。
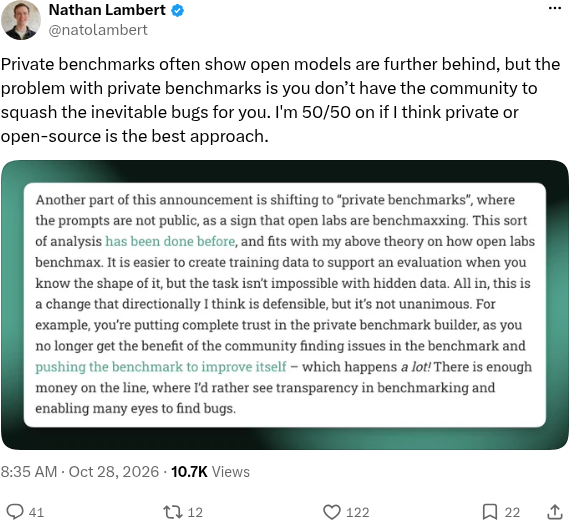
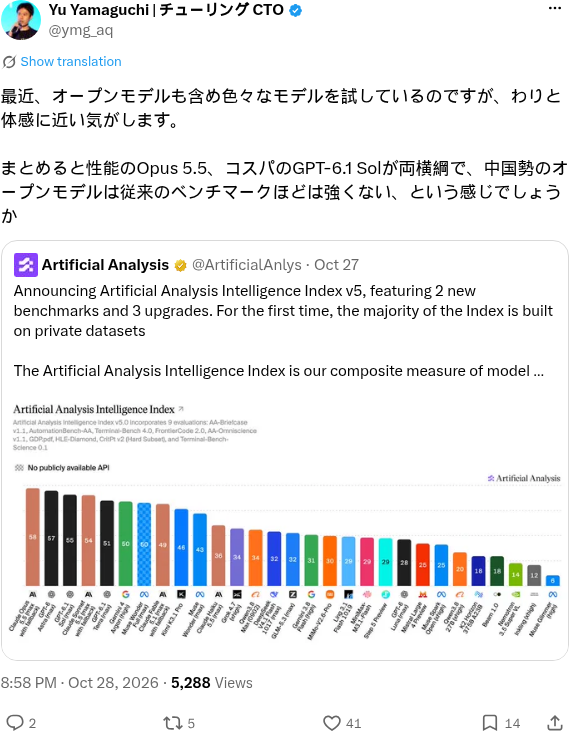
Nathan Lambert 的态度是五五开:私有基准往往显示开放模型差得更远,但私有基准的问题在于,没有社区帮你挑出那些必然存在的 bug。也有人觉得新榜更接近体感,日本开发者 @ymg_aq 说,性能看 Opus 5.5、性价比看 GPT-6.1 Sol,中国开放模型没有旧基准上显示得那么强。
新榜单第一名调不到 API。能下载权重的模型里,最好的排第 38。
资料来源:Artificial Analysis 官网(v5 发布文章、方法论页、排行榜,2026-11-01 抓取);v4.3.2 分数取自 2026-10-26 01:02 UTC 的 Wayback 存档;Gemini 4 Carbon 评测文章(2026-10-28);AA-Omniscience v1.1 说明帖;Interconnects。排名把每个推理档位单独算一行。
资料来源
- Artificial Analysis:Intelligence Index v5 发布文章
- Artificial Analysis:Intelligence Index 方法论
- Artificial Analysis:模型排行榜(v5)
- Wayback 存档:v4.3.2 排行榜(2026-10-26)
- Artificial Analysis:Gemini 4 Carbon 登顶
- Artificial Analysis X 帖:AA-Omniscience v1.1
- Nathan Lambert(Interconnects):Artificial Analysis v5 and the benchmarker's dilemma