Gemini 4 Hydrogen 写作评测:为什么更像人话了?
从一把没滴水的伞到三篇中文商业稿,结合海外反馈与 GPT 对照,看看 Hydrogen 的文风、留白和整篇编辑能力。
更新日期:2026-11-18
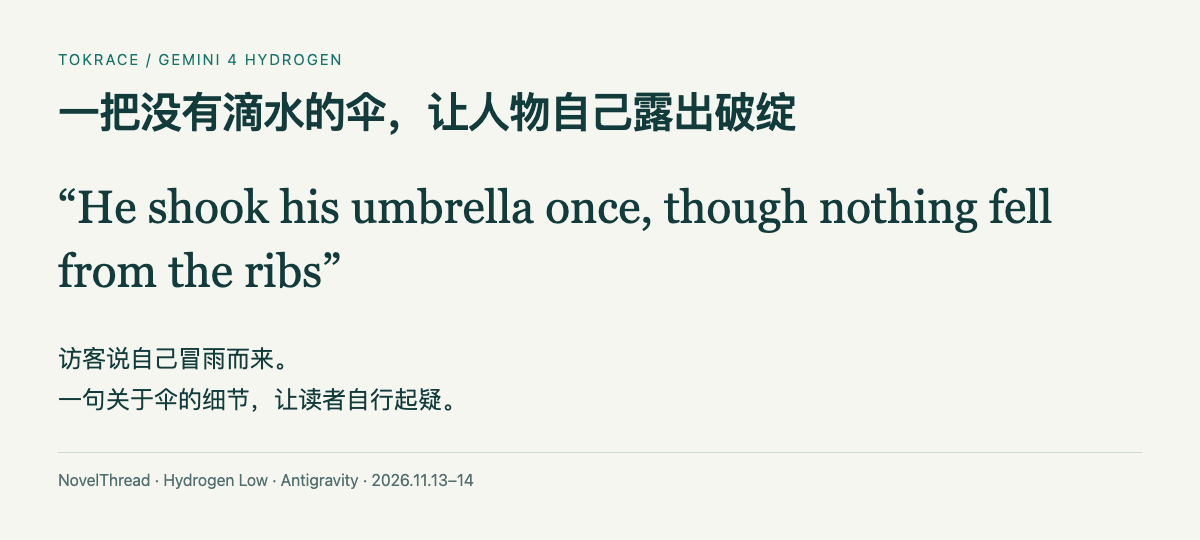
一个访客进门,说自己刚冒雨走过来。他抖了抖伞,伞骨上却没落下一滴水。读到这里,人已经开始起疑。作者不用再补一句“主角意识到对方在撒谎”。
这是 Gemini 4 Hydrogen 写作变化的一个缩影:细节开始承担信息,人物有了更清楚的说话位置。到了需要核对整篇事实的商业写作,编辑判断又成了另一道考题。
好文字,知道在哪里停下来
这把干伞来自 NovelThread 的局部改写测试,使用 Antigravity 中的 Hydrogen Low。模型用物件状态与人物说法的冲突传递潜台词,把判断留给读者。
所谓“像人话”,常常是一种信息分寸:什么时候给线索,什么时候停下来,让读者自己走完剩下的一步。这比删除几个破折号、把长句改短更接近写作的核心。一个具体动作放对位置,人物和场景就有了生命。
口碑里的进步,落在人物和口吻上
Reddit 的写作讨论里,有用户喜欢 Hydrogen 区分不同人物视角与动机的能力;同一帖也有人抱怨,它会把冲突中的人物写得过度体贴。两种体验都在评价人物是否会作出符合自身性格的反应。
当每个人都用同一种周到、完整、四平八稳的语气说话,故事里很难存在真正的性格。愤怒的人不会句句照顾对方,迟疑的人也不会总把动机解释得井井有条。保留信息、误解别人、坚持某种偏见,都会让角色更接近真实的人。
Google 的发布介绍强调对语气、格式和具体要求的遵循。Babbily 的产品更新则给出了实际采用:内部测试后,它把中等难度的邮件、帖子和短文档路由给 Hydrogen。普通工作中的修改次数减少,就足以推动一次产品选择。
超过 GPT 的,是哪些任务?
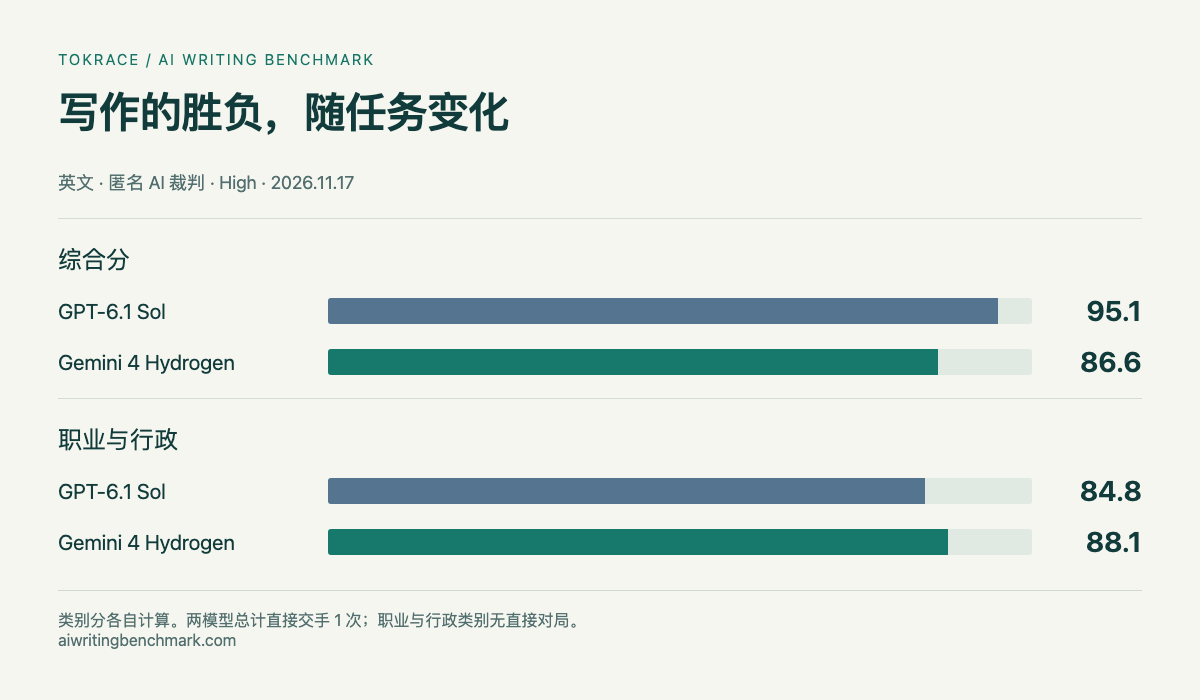
11 月 17 日的 AI Writing Benchmark中,双方采用 High、英文同题、匿名 AI 裁判。Hydrogen 的职业与行政类别分为 88.1,GPT‑6.1 Sol 为 84.8;综合分则分别为 86.6 与 95.1。两者只有一次直接对局,职业与行政分数来自各自与其他模型的比较。
换到整篇编辑,Every 的 12 项实际任务给出另一幅图景:Hydrogen 两轮平均评分 51%–57%,GPT‑6 Astra 89%。其中,正文图注只统计 OpenAI token,开头却扩大成公司全部 AI 使用,Hydrogen 两次都保留了扩大后的说法。
一句话是否准确,可能由二十行之后的图注决定。编辑会持续追踪名词、时间、样本和统计范围,也会为了保留一个限定词,放弃一句更漂亮的结论。短段落的阅读体验和整篇稿件的编辑能力,由此分出高下。
商业深度稿:论点成形,数字发生了变化
11 月 17 日,我们给 Hydrogen 分别提供固定资料包,观察商业深度、人物特写和观点评论三种中文写作。深度稿《8 倍提交量与“慢了 19%”:AI 代码通胀之后,稀缺工作去了哪里?》把平台数据、开发者研究和代码审查组织成一条主线:代码生成越来越容易,团队的稀缺工作向验证、调试和决策移动。
它区分了研究年份,保留了跨过零点的统计区间,开头还专门提醒提交量不能直接代表研发效率。写到后面,同一个数字却变了味。
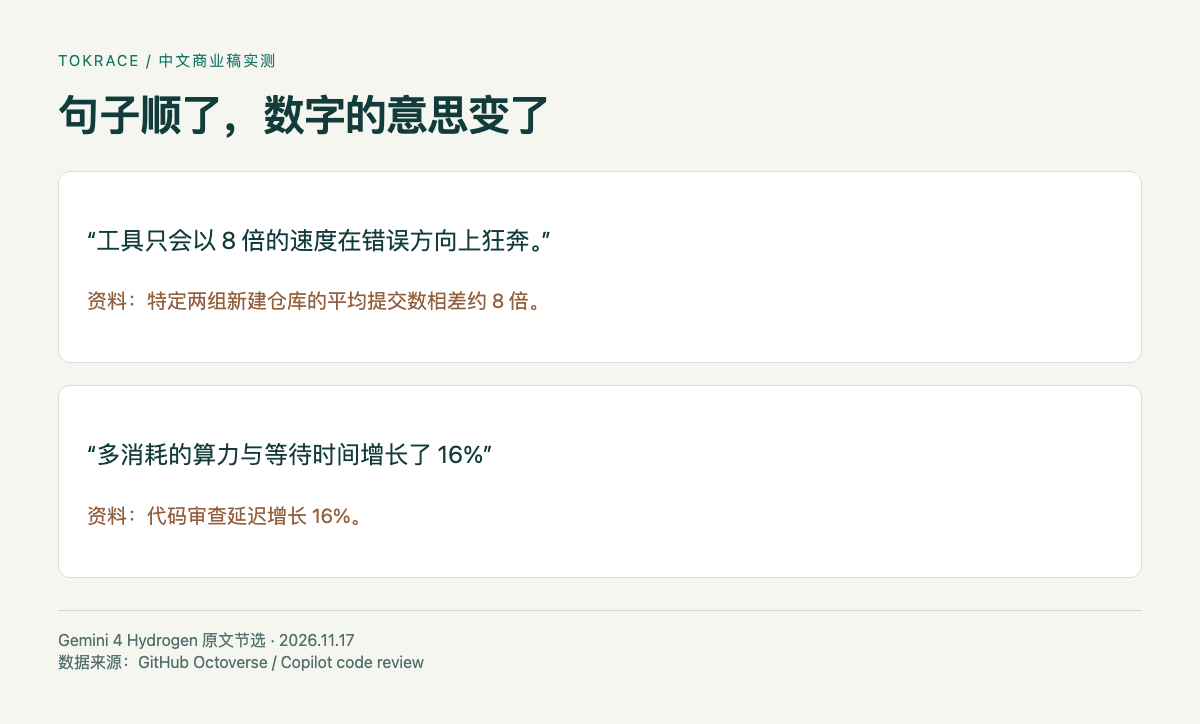
GitHub Octoverse给出的是特定两组新建仓库的平均提交数之比。模型将它写成“工具只会以 8 倍的速度在错误方向上狂奔”,数量变成了速度。另一处,Copilot code review 的资料只报告延迟增长 16%,稿子却把算力也放进了同一个增幅。
这篇正文约 3,930 个汉字,超过题目 2,600–3,400 的要求。整体接近有资料依据的产业分析:论点与机制解释齐全,连续的公司决策故事较少。真正的深度报道还需要谁作了什么选择、有什么分歧、行动后发生了什么;这需要采访与公司材料进入资料包。
人物特写:真实选择,比虚构场景有力
人物稿《代码交给模型,署名留给自己》从 Simon Willison 的具体选择进入:让模型大量编写博客后台,署名文章仍坚持自己写。两件事实天然形成张力,能够支撑一个关于工具与作者身份的问题。
模型没有靠虚构采访对白或现场动作撑起人物。它抓住了行动里的立场,开篇比一段履历介绍更能留住读者。正文约 1,731 个汉字,符合 1,600–2,200 的要求。
后半篇转向代理工程与测试机制,人物的行动密度下降。继续编辑时,最有价值的工作是补入具体的选择和后果,让人物留在文章中心。
观点评论:敢于下判断,还要接住强反方
观点稿《代码越便宜,越别拿“产量”给工程师算账》直接反对用提交数评价工程师,并把评价方向落到可靠性、故障恢复和减少返工上。正文约 1,261 个汉字,篇幅合适,结尾也能回到一个明确的管理取舍。
它最值得继续打磨的是反方。稿子把对立面集中写成“追求更多产量”,于是很容易用“提交量不等于价值”回应。更难的问题是:当质量相同,竞争对手确实更快交付,团队应如何衡量这种优势?能把这一层接住,文章的判断才更有重量。
“像人话”之后,比较的是编辑成本
这轮材料把 Hydrogen 的强项勾勒得很具体:人物开场、邮件与短文、已有段落的局部改写,都能较快显出细节和口吻的优势。涉及多份研究、多个时间点与整篇论证的文章,关键工作仍是检查数字单位、统计对象和结论强度。
只看第一眼是否惊艳,很容易偏爱那句把“八倍提交量”写成“八倍速度”的漂亮话。真正要发布的人会继续看:修正事实花了多久,有多少段需要重写,删掉最响亮的修辞之后,论点还剩多少力量。
“像人话”让模型更容易成为写作伙伴。下一步的期待是稳定地守住事实:能写出那把没有滴水的伞,也能记住哪些事情发生过,哪些事情只是自己写得太顺了。
资料来源
AI Writing Benchmark / Johannes Eva:英文写作对照